Bir yapay zekâ aracına “Bu fonksiyonu açıkla” yazdığınızda birkaç saniye içinde anlaşılır bir yanıt alabilirsiniz. Aynı araç bazen var olmayan bir fonksiyon önerebilir veya projenizdeki önemli bir ayrıntıyı atlayabilir. Bu iki durumun birlikte yaşanması çelişki değildir. Üretilen yanıtın nasıl oluştuğunu bilmek, aracı hangi işte kullanacağınızı ve sonucu nasıl değerlendireceğinizi belirler.
Bu yazı, Yapay Zekâ ile Yazılım Geliştirme eğitiminin birinci dersini tamamlar. Amacımız matematiksel ayrıntılara girmekten önce, geliştirme sırasında karşımıza çıkan kavramları yerli yerine koymak. Seri boyunca küçük bir görev listesi uygulamasını örnek alacağız. Buradaki veriler ve kodlar öğretim amacıyla hazırlanmıştır.
Yapay zekâ, üretken yapay zekâ ve LLM
Yapay zekâ; sınıflandırma, tahmin, planlama ve içerik üretme gibi farklı işleri kapsayan geniş bir alandır. Bir e-postayı istenmeyen ileti olarak sınıflandıran sistemle yeni bir e-posta taslağı yazan sistem aynı işi yapmaz. İkincisi, yeni içerik üretmesi nedeniyle üretken yapay zekâ örneğidir.
Büyük dil modeli, İngilizce kısaltmasıyla LLM, dil örüntülerini kullanarak metin işleyebilen ve üretebilen model türüdür. Kod da belirli sözdizimi ve ilişkiler taşıdığı için bu modeller yazılım geliştirmede kullanılabilir. Bir hatayı açıklatabilir, bir fonksiyon için alternatif isteyebilir veya kodun davranışını adım adım inceletebilirsiniz. Bu beceriler, modelin her yanıtının doğru olduğu anlamına gelmez.
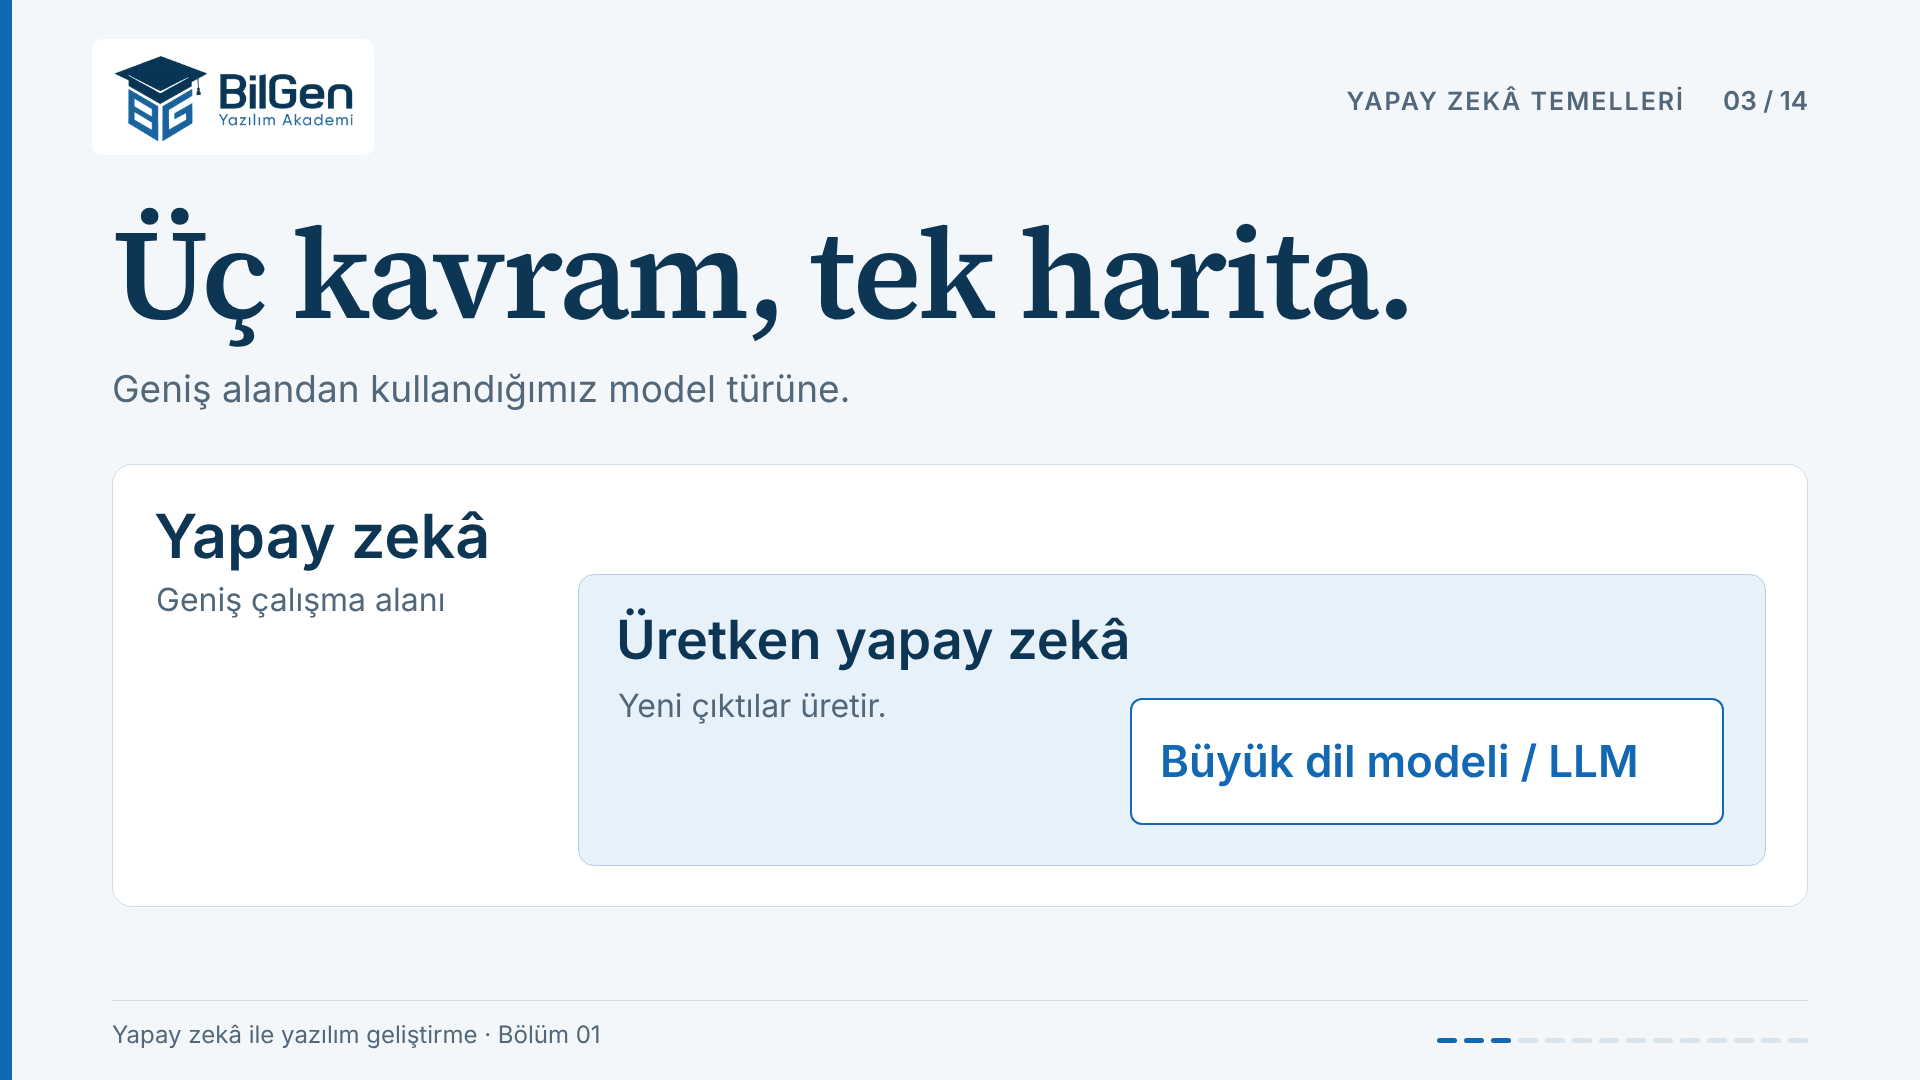
Şekil 1. Dersin sadeleştirilmiş kavram haritası. Yapay zekânın bütün alanlarını sınıflandıran eksiksiz bir teknik taksonomi olarak okunmamalıdır.
Geliştirmeye başlarken yararlı soru şudur: “Bu işte içerik üretmeye mi, mevcut bilgiyi açıklamaya mı, yoksa gerçek bir sistemi çalıştırmaya mı ihtiyacım var?” İlk iki iş modelin yanıt üretmesiyle yapılabilir. Üçüncü iş, dosyalarla ve çalıştırma araçlarıyla bağlantı gerektirir.
Eğitim ile yanıt üretme arasındaki fark
Eğitim sırasında modelin parametreleri çok sayıda örnek üzerinden ayarlanır. Kullanım sırasında ise modele bir girdi sunulur ve bu parametrelerle bir çıktı üretilir. Bu ikinci aşama çıkarım olarak adlandırılır.
Bir konuşmaya proje açıklaması eklediğinizde model bu bilgiden o isteği yanıtlarken yararlanabilir. Bu, modelin yeniden eğitildiği anlamına gelmez. Aynı şekilde yeni bir sohbet açtığınızda, önceki konuşmadaki bütün ayrıntıların otomatik olarak erişilebilir olduğunu varsayamazsınız. Uygulamanın sunduğu geçmiş, bellek ve proje özellikleri ile model eğitimi ayrı konulardır.
Görev listemizde kayıtların title alanında tutulduğunu düşünelim. Bu bilgiyi paylaşmak, modelin name gibi yanlış bir alan varsaymasını azaltır. Fakat modele bütün yazılım dünyası için kalıcı bir kural öğretmiş olmazsınız; mevcut işin bağlamını açıklamış olursunuz.
Model ile kullandığınız uygulama aynı şey değildir
Ekranda gördüğünüz sohbet kutusu, dosya paneli ve “çalıştır” düğmesi bir uygulamanın parçalarıdır. Model yanıt üretir; uygulama ise dosya okuma, komut çalıştırma ve araç sonuçlarını konuşmaya geri ekleme gibi yetenekler sunabilir. Aynı model farklı uygulamalarda farklı iş akışlarının içinde kullanılabilir.
Bu ayrımı anlamak beklentiyi düzeltir. “Model kod yazabiliyor” cümlesi, kullandığınız arayüzün bilgisayarınızdaki dosyaları değiştirebildiğini göstermez. Dosya değiştiren bir araç olması da değişikliğin otomatik olarak test edildiğini göstermez. Her adımın gerçekten gerçekleştiğini ayrı değerlendirmek gerekir.
Token neden kelime demek değildir?
Modelin işlediği metin, token adı verilen parçalara ayrılır. Bir token tam bir kelimeye, kelimenin bir bölümüne veya bir işarete karşılık gelebilir. Türkçe ekler, noktalama işaretleri ve kod parçaları nedeniyle “yüz kelime eşittir yüz token” gibi bir hesap kullanamayız. Kesin sayı, kullanılan modele ve onun token ayırma yöntemine bağlıdır.
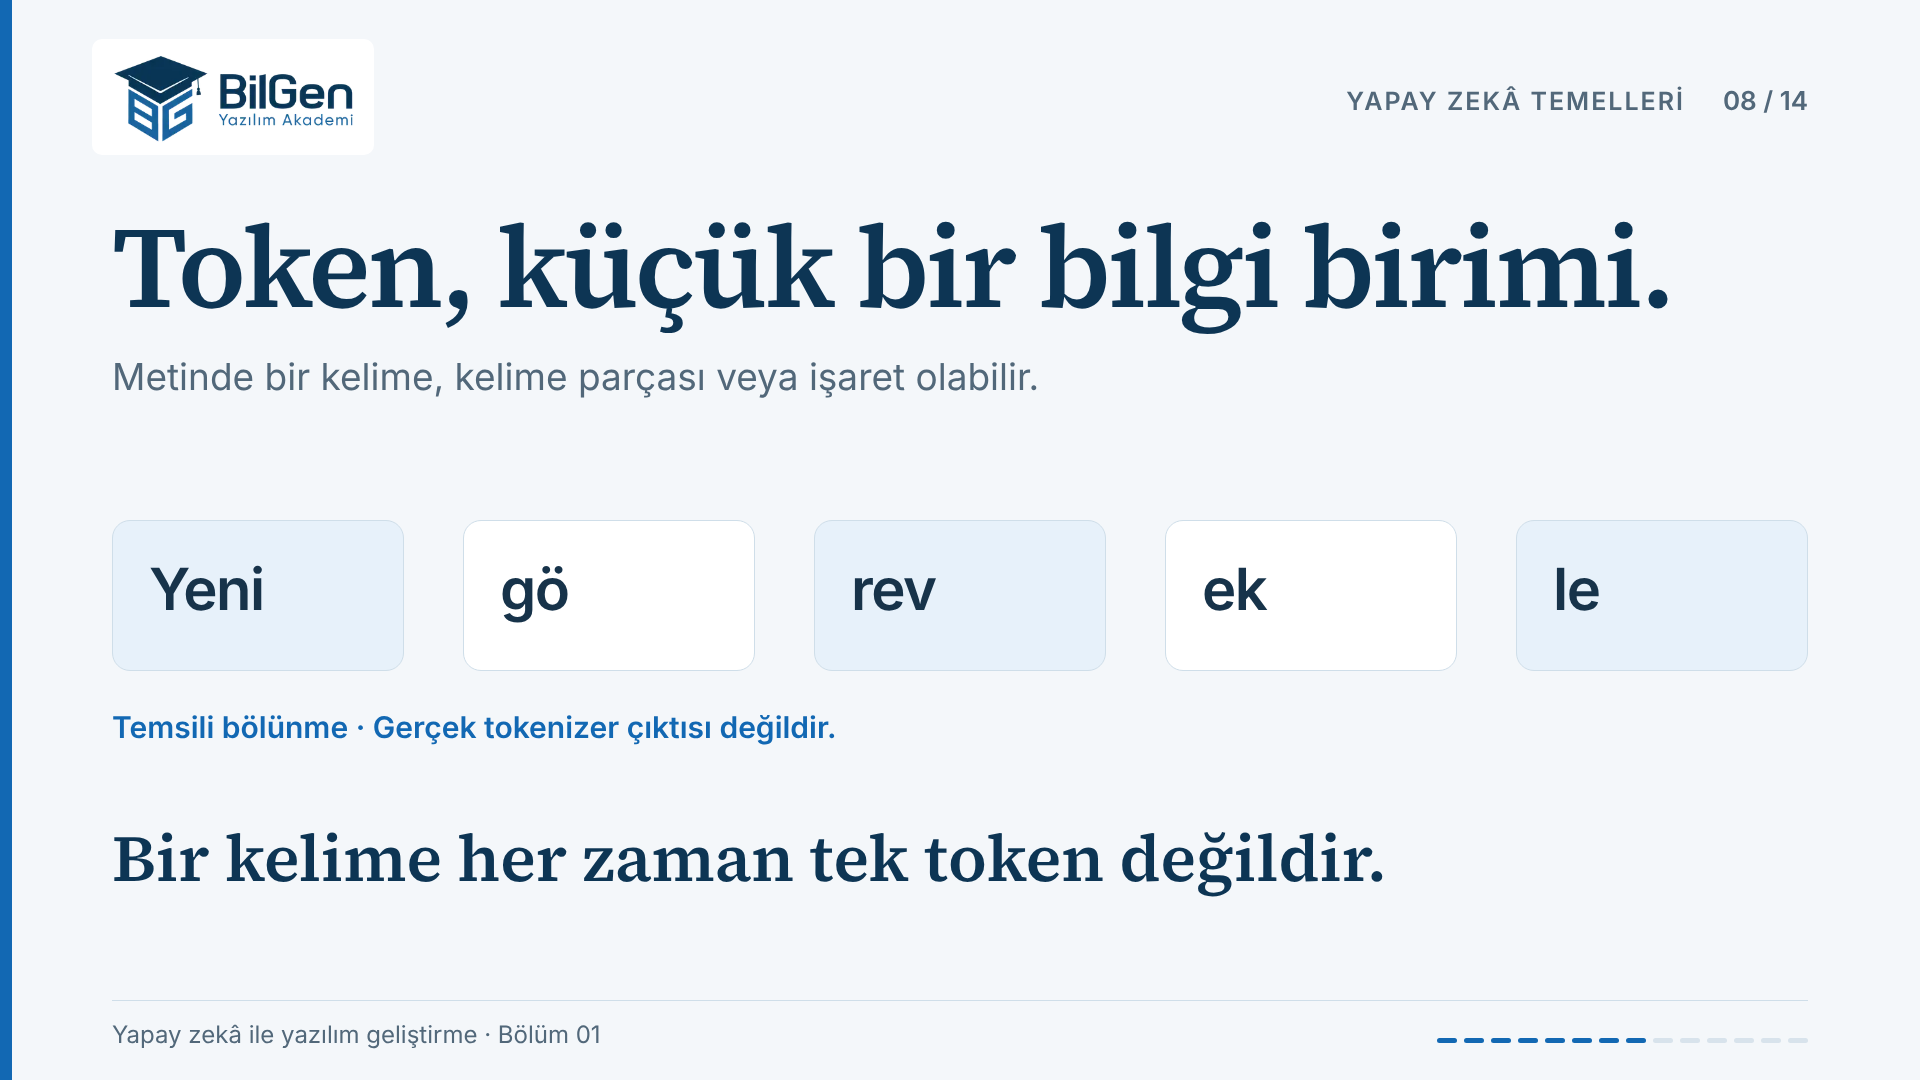
Şekil 2. Token parçaları öğretim amaçlıdır; belirli bir modelin gerçek token dökümü değildir.
Token kavramı pratikte iki nedenle işimize yarar. Öncelikle bir istekte ne kadar içerik taşınabileceğini anlamayı sağlar. Ayrıca kullanımın nasıl ölçüldüğünü yorumlamaya yardım eder. Bununla birlikte yalnızca metni kısaltmak iyi bir hedef değildir. Önemli bir veri alanını silerek birkaç kelime kazanmak, yanlış bir çözümle çok daha fazla uğraşmanıza neden olabilir.
Bağlam: modelin bu iş için gördüğü bilgiler
Bağlam; isteğiniz, konuşmanın ilgili kısmı, eklenen dosyalar, proje talimatları ve araç sonuçları gibi modele sunulan bilgilerin bütünüdür. Bağlam penceresi, modelin bir işlemde ele alabildiği içeriğin sınırını anlatır. Uygulamanın bu alanı nasıl kullandığı değişebilir; uzun geçmişin bir bölümü özetlenebilir veya her dosya her isteğe eklenmeyebilir.
Bir dosyanın editörde açık olması, modelin o dosyanın tamamını kesin olarak gördüğünü kanıtlamaz. Bu yüzden “Şu fonksiyonun bulunduğu dosyayı incele; title alanının nerede üretildiğini kontrol et” gibi somut yönlendirmeler yararlıdır. İlgili dosyayı, veri örneğini ve beklenen davranışı birlikte vermek; ilgisiz bütün proje dosyalarını eklemekten daha anlaşılır bir çalışma zemini oluşturur.
Bu ayrımların teknik arka planı için VS Code’un dil modelleri rehberi ve bağlam rehberi incelenebilir.
Küçük bir kod örneğini gerçekten anlamak
Aşağıdaki JavaScript örneği, tamamlanan görevleri seçer. tamamlandi alanının her kayıtta bir mantıksal değer olduğu varsayılmıştır.
const gorevler = [
  { id: 1, title: "Dersi kaydet", tamamlandi: true },
  { id: 2, title: "Notları düzenle", tamamlandi: false },
  { id: 3, title: "Görselleri seç", tamamlandi: true },
];

const tamamlananlar = gorevler.filter(
  (gorev) => gorev.tamamlandi
);

console.log(tamamlananlar.map((gorev) => gorev.id));
// Beklenen değer: [1, 3]filter, her görev için koşulu değerlendirir ve koşulu sağlayanları yeni bir diziye alır. Kaynak diziden kayıt silmez. Buradaki yeni dizi, nesnelerin derin kopyasını oluşturmaz; seçilen nesnelere aynı başvuruları taşır. Başlangıçta bu son ayrıntıyı ezberlemek zorunda değilsiniz, ancak “yeni dizi” ile “tamamen bağımsız yeni nesneler” ifadelerinin aynı anlama gelmediğini bilmelisiniz.
Kodu incelerken üç soru sorun: Girdi hangi biçimde? Koşul tam olarak neyi seçiyor? Beklenen sonuç hangi kayıtlar? Böylece yalnızca satırların Türkçe açıklamasını almakla kalmaz, davranışı da takip edersiniz.
Akıcı yanıt neden doğrulama gerektirir?
Model, kulağa uygun gelen fakat gerçek olmayan bir API adı üretebilir. Buna sıkça halüsinasyon denir. Kendi içinde tutarlı bir açıklama da yanlış bir varsayıma dayanabilir. Örneğin yukarıdaki veride alan tamamlandi iken önerilen kod completed kullanıyorsa, sorun JavaScript bilgisinden önce proje bilgisinin yanlış kurulmasıdır.
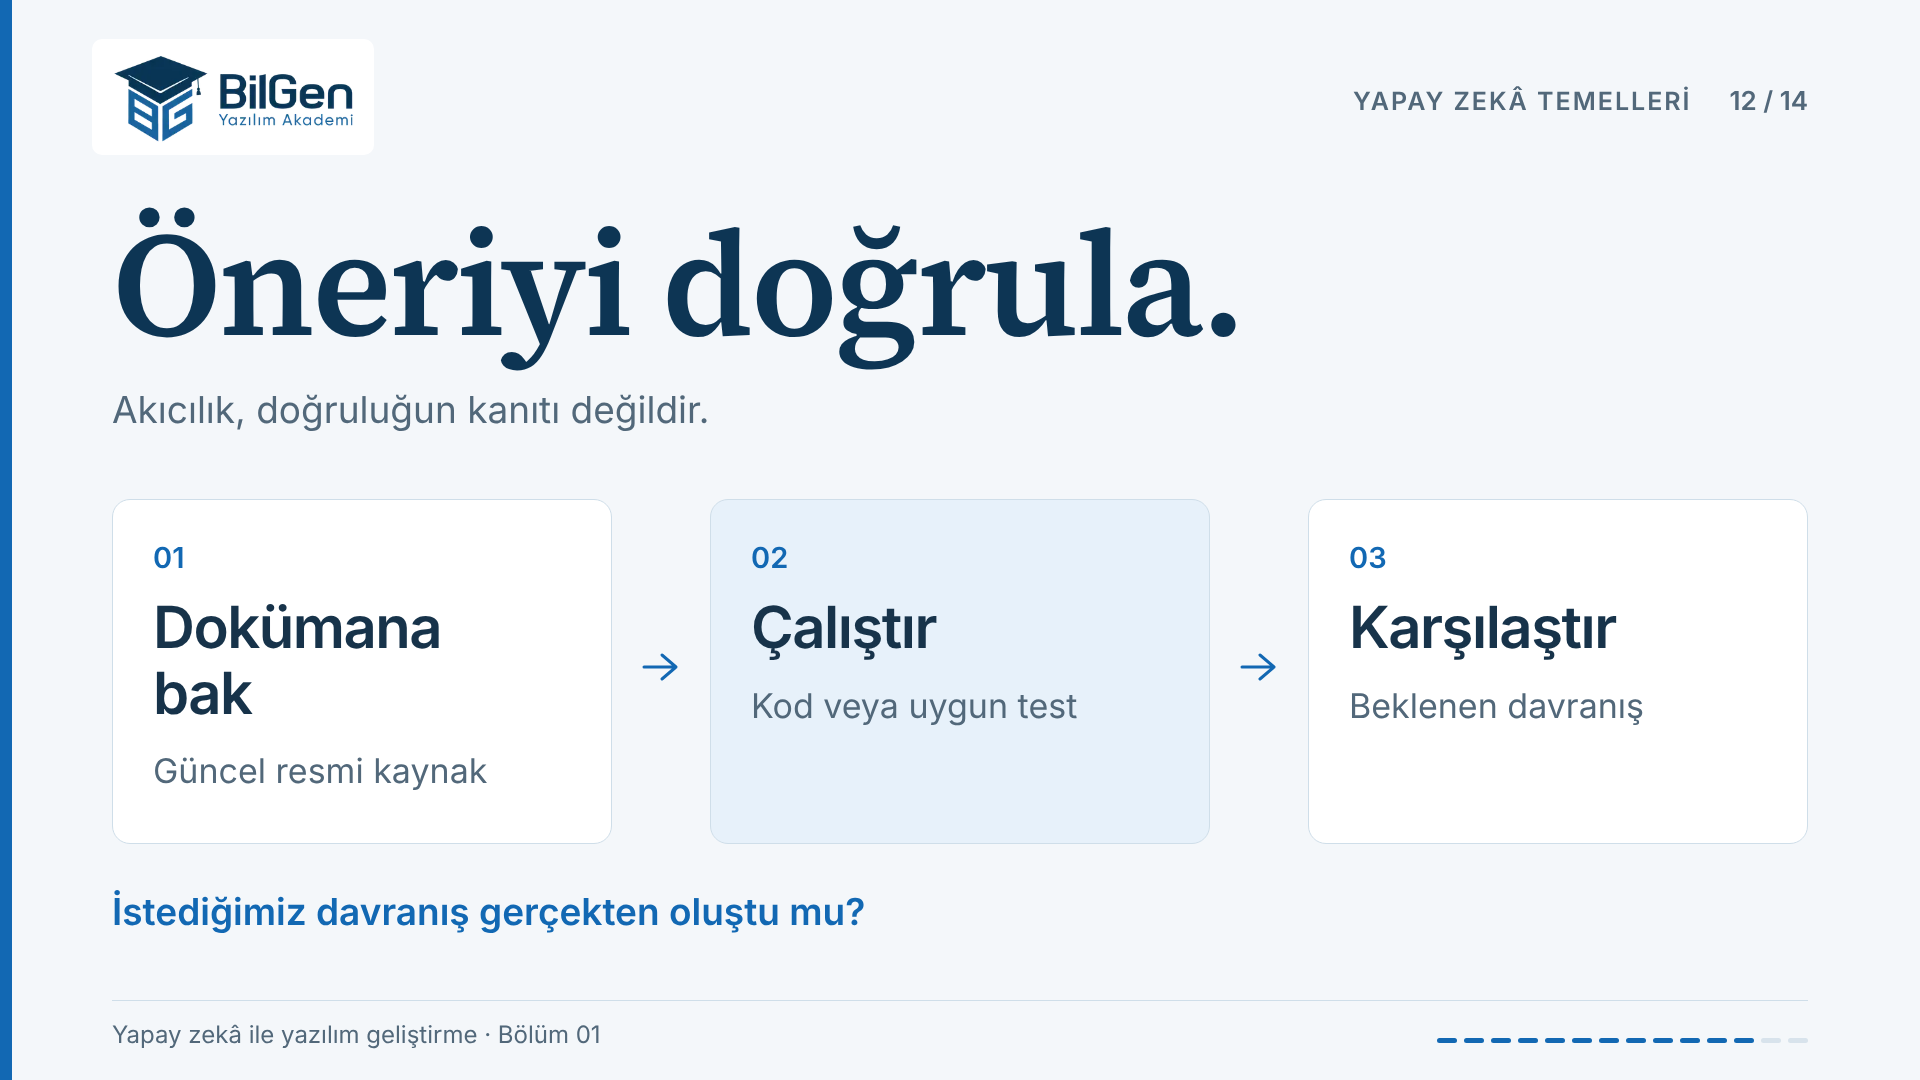
Şekil 3. Açıklamayı anlamak, kullanılan yapıyı kontrol etmek ve beklenen davranışı denemek birbirini tamamlar.
Bir kütüphane fonksiyonu önerildiğinde resmi belgede gerçekten var olup olmadığını ve projenizdeki sürümde desteklenip desteklenmediğini kontrol edin. Ardından küçük, sonucu öngörülebilir bir örnekle deneyin. “Çalışması gerekir” ile “bu girdilerle çalıştırıldı ve şu sonucu verdi” farklı kanıt düzeyleridir.
Uygulama: açıklamadan davranışa geçin
Yukarıdaki listeye tamamlanmamış bir dördüncü görev ekleyin. Kodu çalıştırmadan önce sonuçta hangi kimliklerin bulunacağını yazın. Sonra koşulu !gorev.tamamlandi olarak değiştirip bu kez hangi kayıtların seçileceğini tahmin edin. Beklenen sonuç ilk durumda yine 1 ve 3; ikinci durumda 2 ve eklediğiniz yeni görevin kimliğidir.
Ardından yapay zekâya yalnızca “Bu kodu açıkla” demek yerine şu isteği verin:
Bu kodun girdisini, seçim koşulunu ve sonucunu ayrı ayrı açıkla.
Kaynak dizinin değişip değişmediğini belirt.
Alan adlarını paylaştığım örnekten kontrol et.
Sonucu doğrulamak için iki küçük girdi öner.
Artık model, uygulama, token ve bağlam arasındaki farkı ayırt edebilirsiniz. İkinci derste, bu bilgiyi kullanarak hangi iş için hangi çalışma biçiminin uygun olduğunu değerlendireceğiz.